Introduction à R
École interdisciplinaire outils & méthodes (EIOM)
Midi-métho
24 août 2026
Plan
- Introduction à R
- Les applications de R dans la recherche
- Pourquoi utiliser R en recherche ?
- Exemple pratique
- R et intelligence artificielle
- Le rôle du chercheur à l’Ère de l’IA
1. Introduction à R
1.1 R : Langage et environnement logiciel libre
Permets d’analyser, transformer et visualiser des données
Libre et gratuit, développé et maintenu par la R Core Team
Un écosystème extensible grâce aux packages
Packages spécialisés = répondre facilement à des tâches spécifiques
24752 packages sur CRAN (Comprehensive R Archive Network)
GitHub héberge également de nombreux packages et projets R
1.2 R : Une calculatrice
mean(c(1, 2, 3)) → 2
«Calculatrice» → R peut effectuer des calculs complexes.
«Feuille de papier» → Permets d’écrire toutes les étapes du raisonnement et de les conserver.
«Automate» → R peut exécuter automatiquement les étapes.
1.3 Le code comme trace de l’analyse
Une commande est une instruction du langage R.
Les commandes sont inscrites dans le code, chaque opération laisse une trace.
La combinaison de commandes forme un script.
Un script est ainsi reproductible, versionnable, auditable.
1.4 Positron et RStudio: Environnements de développement
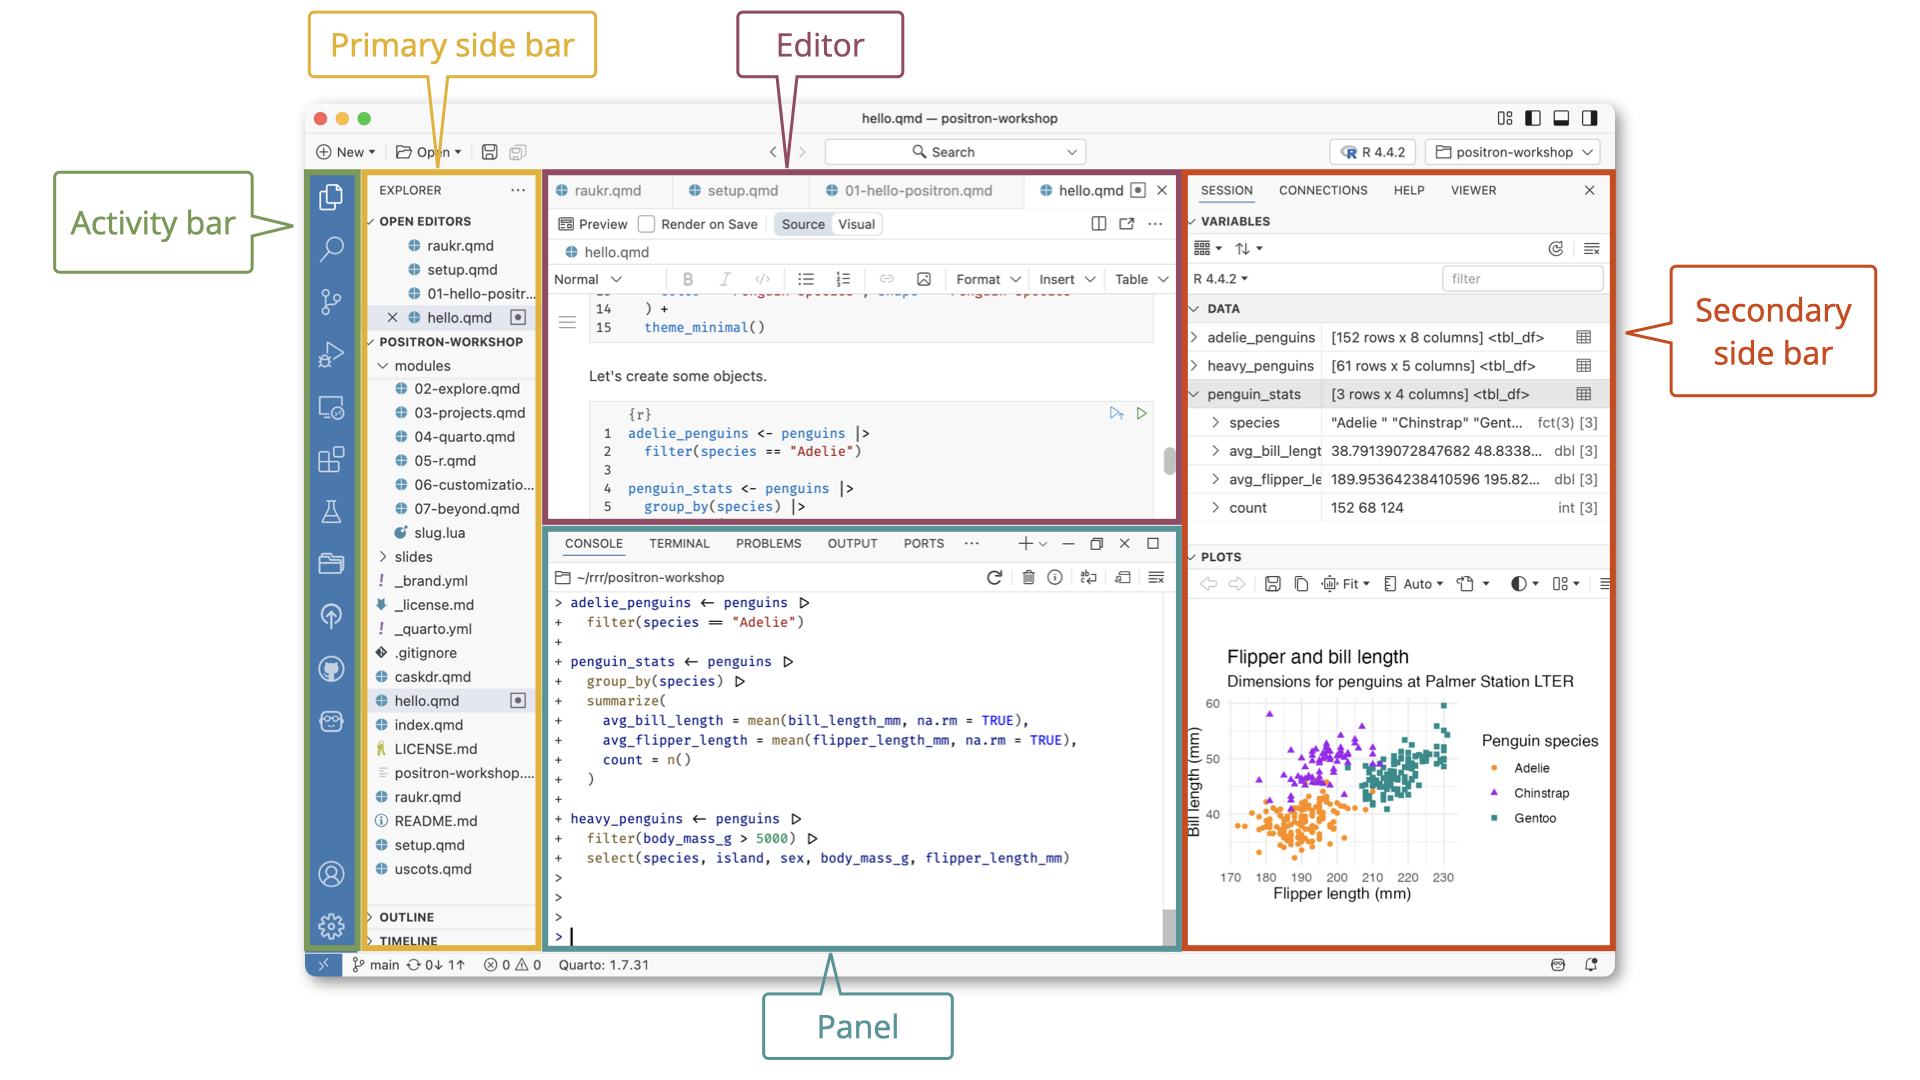
Positron
1.5 Comprendre la logique de R : objets, fonctions et scripts
- Objet : ce que R garde en mémoire (
x <- 5) - Fonction : une action sur des objets (
mean(x)) - Script : une suite d’instructions reproductible
2. Les applications de R dans la recherche
2.1 Importer et structurer les données
Depuis n’importe quel format
- CSV
- Excel
- SPSS
- JSON
- TXT
- etc.
2.2 Nettoyer, transformer et préparer les données
Data cleaning & Data wrangling
- Renommer, filtrer, réordonner, joindre, agréger
- Traiter les valeurs manquantes
- Changer la forme des tableaux
2.3 Explorer les données
- Statistiques descriptives
- Distributions
- Corrélations
- Anomalies
2.4 Analyser les données
- Régressions (linéaires, logistiques, ordinales, etc.)
- Données longitudinales et modèles multiniveaux
- Méthodes causales (expériences, diff-in-diff, variables instrumentales)
- Analyse de réseaux sociaux
- Analyses factorielles et modèles de variables latentes
Tout est accessible via les packages CRAN.
2.5 Visualiser les données
Data visualization
ggplot2 : package permettant de construire n’importe quel graphique.
2.6 Automatiser, reproduire et documenter son travail
- Gagner en rapidité
- Rejouer un pipeline entier en une commande
- Traiter 1 000 fichiers avec le même script
- Chaque analyse laisse une trace, soit le script.
3. Pourquoi utiliser R en recherche ?
3.1 Développer une meilleure compréhension de ses données
- Explorer les données
- Décrire leurs caractéristiques
- Identifier les incohérences
- Comparer les observations et les groupes
- Tester différentes transformations
- Questionner les résultats
3.2 Garder le contrôle sur ses analyses
- Rendre explicites les transformations
- Comprendre ce qui se passe derrière les résultats
- Pouvoir revenir sur ses décisions méthodologiques
3.3 Améliorer la reproductibilité
Un script c’est une analyse qui peut être reproduite à l’identique.
4. Exemple pratique
4.1 Partir d’une question de recherche
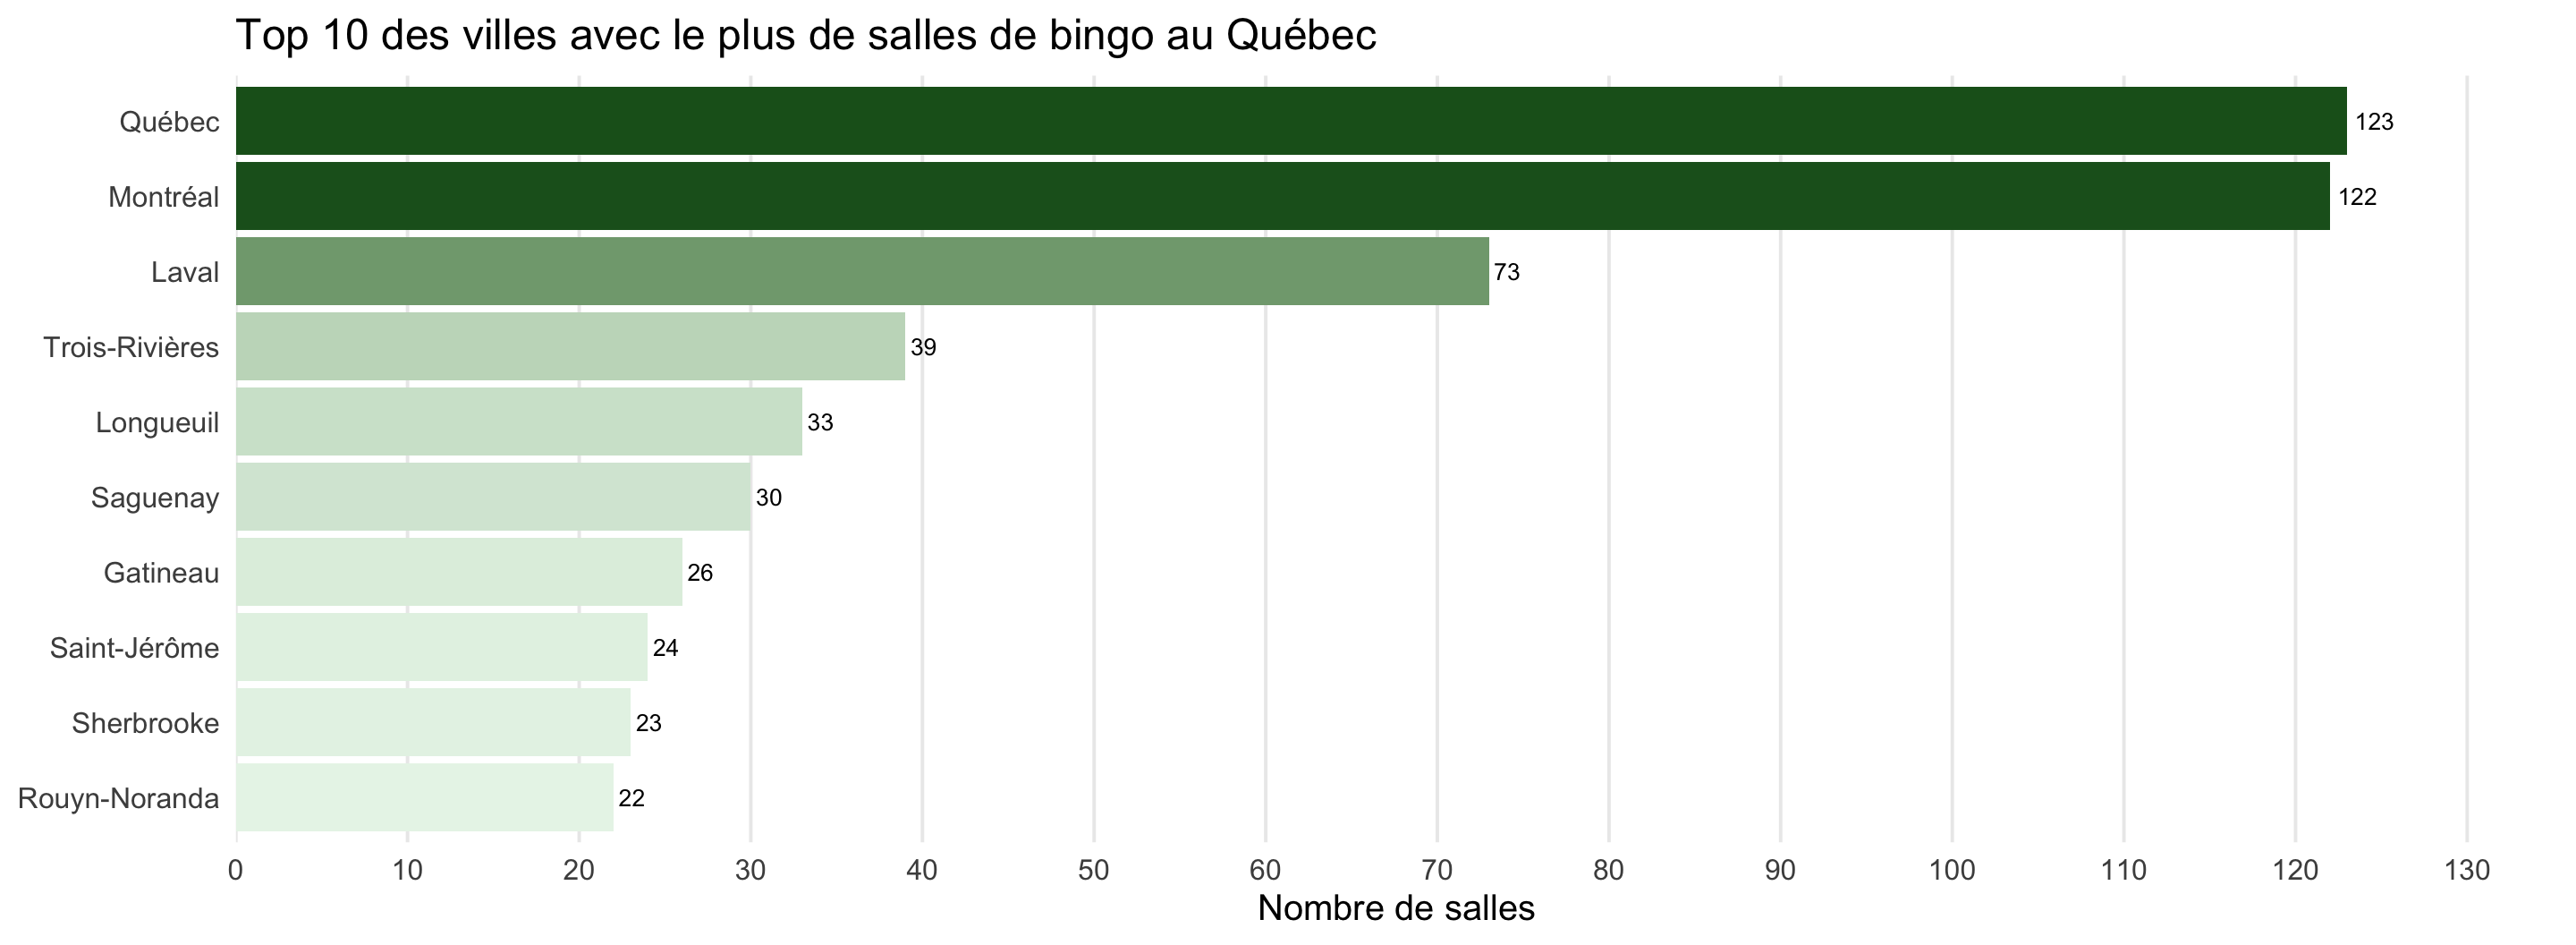
Où concentre-t-on les salles de bingo au Québec ?
4.2 Importer les données
df_bingo est maintenant un objet en mémoire : un tableau (data frame).
4.3 Explorer la structure et le contenu des données importées
4.4 Nettoyer et transformer les données
4.5 Visualiser les résultats (le code)
ggplot(df_top10, aes(x = n,
                     y = reorder(Ville, n),   # trie les villes par n croissant
                     fill = n)) +             # couleurs proportionnelle aux salles
  geom_col() +                                # une barre horizontale par ville
  geom_text(aes(label = n), hjust = -0.2, size = 3.5) + # valeurs numériques au bout
  scale_fill_gradient(low = "#e8f5e9",
                      high = "#1b5e20") +   # couleurs des colonnes
  scale_x_continuous(expand = expansion(mult = c(0, 0.1)), # ajustement de la marge
                     breaks = seq(0, 150, by = 10)) + # gradation axe des x
  labs(
    title = "Top 10 des villes avec le plus de salles de bingo au Québec", # titre
    x = "Nombre de salles",                   # ajoute titre axe des x
    y = NULL                                  # enlève titre axe des y
  ) +
  theme_minimal(base_size = 15) +
  theme(
    legend.position = "none",                 # suppression de la légende
    panel.grid.major.y = element_blank(),     # grille horizontale supprimée
    panel.grid.minor.x = element_blank()      # grille entre la gradation supprimée
)4.6 Visualiser les résultats (le graphique)
5. R et intelligence artificielle
5.1 L’IA comme assistant de programmation
- Générer du code
- Expliquer du code
- Corriger des erreurs
- Proposer des approches alternatives
5.2 L’IA permet d’aplatir la courbe d’apprentissage
- Pas besoin de mémoriser toute la syntaxe
- Permets de poser une question en langage naturel
- Apprendre au fur et à mesure de ses besoins
5.3 Pourquoi comprendre R reste essentiel
- Savoir formuler de bonnes demandes à l’IA (avoir les intuitions)
- Comprendre ce que fait le code généré
- Identifier les erreurs ou mauvaises interprétations
- Comprendre les structures de données et leurs conséquences
- Rester maître des décisions scientifiques
5.4 Mais l’IA peut aussi avoir de « bonnes intuitions »
- Elle propose parfois des solutions pertinentes
- Elle identifie des problèmes auxquels le chercheur n’a pas pensé
- Elle peut dépasser les connaissances immédiates du chercheur
Mais le traitement des données est lui-même un choix méthodologique. L’IA peut proposer des options, mais c’est au chercheur d’en évaluer les implications et de choisir.
6. Le rôle du chercheur à l’ère de l’IA
6.1 Les données : partie intégrante du processus scientfique
Les données ne sont jamais entièrement neutres ou « brutes ».
Leur structure et leur traitement façonnent les résultats.
Choisir une variable, une agrégation, un seuil, c’est un choix scientifique.
6.2 « Jouer » avec ses données pour mieux les comprendre
- Explorer
- Transformer
- Tester
- Comparer
- Questionner
L’IA peut brouiller ces étapes. Savoir lire et comprendre le code est donc essentiel.
6.3 Garder la maîtrise de son analyse par la lecture du code
- Comprendre ce qui est fait aux données
- Décider & Comprendre les choix méthodologiques
- Vérifier la cohérence du processus
6.4 Ce qui demeure du ressort du chercheur
- Définir la question
- Définir ce que représentent les données
- Faire les choix méthodologiques
- Évaluer la plausibilité des résultats
- Interpréter et contextualiser
Conclusion
L’objectif n’est pas de remplacer le chercheur par l’IA, mais de lui permettre de gagner du temps sur les tâches techniques.
L’IA permets au chercheur de se concentrer sur ce qui est le plus important : la question de recherche, la théorie et les choix méthodologiques.
Pour aller plus loin : Datacamp · capsules du CAPP.
Jules Piral - EIOM - 24 Août 2026